Os autores do artigo ressaltam que a troca rápida de informações certas entre as pessoas certas é fundamental atualmente e que existem diversas aplicações com o objetivo de facilitar a transmissão de informações entre emissores e receptores. Nesse artigo, os autores se aprofundam nos algoritmos e técnicas usados por essas ferramentas para possuirem funcionalidades como reconhecimento de fala, conversão de áudio para texto (speech-to-text) e conversão de texto para fala (TTS – text-to-speech).
O artigo afirma que a fala é considerada a forma mais natural e eficaz de transmitir informações. Com os avanços recentes, tecnologias de reconhecimento de voz têm permitido converter mensagens faladas em texto, dando origem a novas aplicações como a Alexa. A Alexa é uma assistente virtual inteligente incorporada a um dispositivo eletrônico, foi criada para facilitar a interação do usuário com o aparelho e auxiliá-lo de forma mais eficiente na comunicação com serviços locais e/ou remotos, utilizando tecnologias avançadas de reconhecimento de fala e TTS.
O estudo aborda diferentes aspectos da fala e suas transformações como reconhecimento de voz, conversão de fala em texto e vice-versa, além de interpretação de fala. Entre as técnicas empregadas, o artigo destaca o Dynamic Time Warping (DTW), do Hidden Markov Model (HMM) e modelos de redes neurais sticas são técnicas muito usadas em sistemas de reconhecimento e STT.
1) Reconhecimento de Voz
O artigo define reconhecimento de voz como a capacidade de um sistema computacional identificar sons e palavras da linguagem humana e transformá-los em uma forma compreensível para a máquina. Os autores também fornecem as seguintes classificações para sistemas de reconhecimento de voz:
-
Locutor: Cada pessoa possui um modo único de falar. Por isso, os modelos podem ser desenvolvidos para um único usuário específico ou para múltiplos falantes;
-
Forma de pronúncia: A maneira como as palavras são ditas influencia diretamente o reconhecimento. Alguns sistemas conseguem identificar frases completas, enquanto outros reconhecem apenas palavras isoladas, com pausas entre elas;
-
Vocabulário: O tamanho do conjunto de palavras que o sistema é capaz de compreender impacta sua complexidade, desempenho e precisão.
1.1) Forma Primária de Identificação de Voz
O artigo afirma que sistema de reconhecimento de fala seguem um conjunto de etapas fundamentais, como mostrado na imagem abaixo
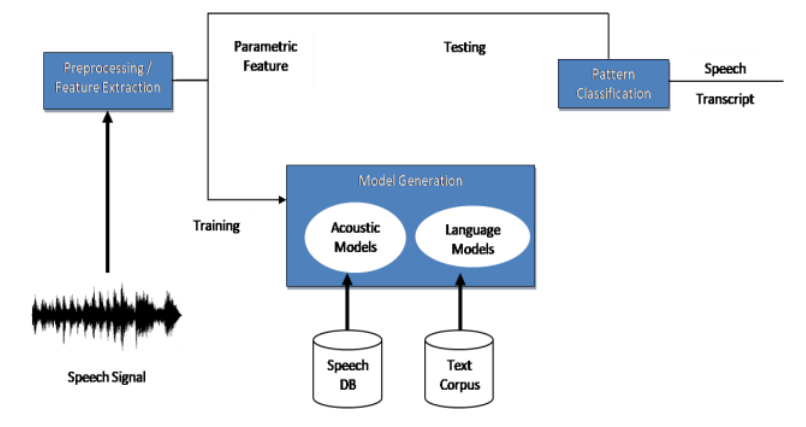
- Pré-Processamento: O sinal analógico da voz é convertido em um sinal digital, permitindo que ele seja processado nas etapas seguintes. Esse sinal digital passa por um refinamento espectral.
- Extração de Características: Nesta fase, um conjunto de critérios de enunciação que permitem a interação por meio de comandos de voz são identificados. Esses critérios/características são extraídos a partir da transformação da forma de onda acústica. O principal objetivo é obter uma sequência de vetores de componentes que forneça uma representação compacta do comando capturado. Existem vários métodos utilizados nessa fase como Linear Predictive Coding (também conhecido como LPC e é baseado no princípio que um fragmento de som em um instante de tempo também é afetado pelos fragmentos que vieram antes dele), Mel-Frequency Cepstral Coefficient (ou MFCC, busca simular a percepção auditiva humana aplicando uma série de transformações ao sinal de entrada), Dynamic Time Warping (ou DTW, ajusta duas sequências temporais para buscar o alinhamento ótimo entre os vetores de características e garante que diferentes formas de pronunciar uma mesma palavra possam ser reconhecidas corretamente)
- Modelos Acústicos: Componentes centrais em sistemas de Reconhecimento Automático de Fala (ASR). Esses sistemas possuem uma correspondência direta entre um sinal sonoro e um fonema.
- Modelos de Vocabulário: Ajudam a prever sequências de palavras e associá-las corretamente à fala registrada
- Comparação de Padrões: Essa etapa consiste em relacionar o padrão de fala desconhecido com modelos de referência e calcular a similaridade entre eles. Entre os métodos mais comuns estão o baseado em padrões (possui um conjunto de modelos de fala coletados como referência, permitindo que palavras sejam reconhecidas ao comparar o áudio com os padrões armazenados), baseado em treinamento (extrai características da fala e treina o sistema para gerar um conjunto de regras que descrevem os sons, possibilitando o reconhecimento mesmo em casos novos), baseado em redes neurais (destinado a lidar com tarefas de reconhecimento mais complexas, combinando informações de diferentes fontes e aprendendo padrões de fala de forma adaptativa) e baseado em análise estatística (o áudio é formado estatisticamente).
2) Métodos de Conversão de Fala em Texto
De acordo com os autores, esses métodos seguem etapas de percepção e extração de características do áudio, podendo combinar técnicas diversas em cada etapa.
2.1) Modelo de Markov Oculto (HMM)
O artigo esse modelo como um modelo estatístico amplamente usado em reconhecimento de voz, porque considera que a fala pode ser representada como sequências de sinais estáveis de curto prazo. Esse modelo é especialmente útil para conversão de voz em texto em tempo real, como em celulares. Ele se baseia em critérios como
- Eficiência no Reconhecimento: O reconhecimento envolve comparar o padrão de áudio desconhecido com modelos de referência e calcular a correspondência entre eles. Esse é um aspecto crucial de qualquer sistema de reconhecimento, devendo funcionar de maneira confiável independentemente do locutor.
- Tempo do Reconhecimento: Os usuários podem ficar impacientes e o sistema perde eficiência se demorar muito para identificar o sinal de voz.
- Pré-processamento: Os sinais de áudio captados são convertidos em estruturas de fala e amostrados individualmente, reduzindo ruídos indesejados.
- Preparação do HMM: No treinamento, o sistema cria um modelo representativo a partir das características extraídas de várias amostras, associando padrões que se assemelham a sons de voz da mesma categoria.
- Reconhecimento pelo HMM: Nesta etapa, o sistema compara os padrões de áudio desconhecidos com os modelos de referência e calcula a similaridade ou distância entre eles. A identificação é feita com base na máxima probabilidade.
2.2) 2.1.2.2 Rede Neural Artificial (ANN) com Otimização Cuckoo Search (CSO)
Esse método é utilizado para melhorar a comunicação, aumentar a precisão do reconhecimento e reduzir ruídos indesejados. Sistemas de reconhecimento automático de fala buscam uma interação mais eficiente entre máquina e usuário, seguindo um fluxo em três etapas. A primeira etapa remove partes desnecessárias da forma de onda. A segunda, dois conjuntos de atributos são extraídos da fala, MFCC (Mel Frequency Cepstral Coefficients) e LPCC (Linear Predictive Coding Coefficients). Na terceira ocorre a classificação, onde os conjuntos MFCC e LPCC são usados como entrada, permitindo que o sistema aprenda padrões e produza uma saída correspondente de forma precisa.