[Link do artigo original](https://www.mdpi.com/2079-9292/12/1/116)
# Framework IoT–Fog–Cloud para Sistemas Inteligentes com Controle de Voz
> **Resumo:**
> O trabalho de Iliev e Ilieva apresenta um framework distribuído IoT–Fog–Cloud (IoTFC) para controle de voz em sistemas inteligentes, com foco em Processamento de Linguagem Natural (NLP).
> A arquitetura propõe descentralizar o entendimento de linguagem para camadas intermediárias (fog), reduzindo dependência de nuvem, custos e latência — um conceito aplicável a sistemas embarcados como o **Echo Dot (5ª geração)**.
---
## Introdução e Contexto
O artigo de **Iliev e Ilieva** propõe uma **arquitetura distribuída IoT–Fog–Cloud (IoTFC)** voltada para sistemas de automação residencial com **controle de voz baseado em NLP**.
O objetivo é transformar expressões verbais em comandos executáveis, oferecendo uma alternativa mais acessível, flexível e independente de plataformas comerciais, que em geral exigem assinaturas, oferecem suporte limitado a idiomas e demandam integração técnica complexa.
A proposta é especialmente relevante para idiomas com poucos recursos linguísticos, como o búlgaro (utilizado no protótipo).
O framework busca democratizar o uso de interfaces de voz e reduzir a dependência de provedores globais, tornando o controle de voz mais autônomo, inclusivo e personalizável.
---
## Arquitetura IoT–Fog–Cloud
A arquitetura é organizada em três camadas principais:
| Camada | Função Principal | Analogia com Echo Dot |
|--------|------------------|-----------------------|
| **Edge (Borda)** | Dispositivos IoT físicos (sensores, atuadores). | Microfones, LEDs e sensores do dispositivo. |
| **Fog (Névoa)** | Processamento local intermediário e integração. | Processador local que detecta a palavra “Alexa”. |
| **Cloud (Nuvem)** | Armazenamento, análise e serviços NLP. | Servidores da Amazon com NLP e dados do usuário. |
O diferencial está na camada Fog, que permite o processamento local, reduzindo latência, uso de banda e riscos de segurança.
Essa camada introduz um servidor de integração, onde é instalado o módulo de Interface Inteligente do Usuário (IUI).
Essa estrutura descentralizada melhora a resposta em tempo real e possibilita operações offline, além de proteger o núcleo do sistema contra vulnerabilidades.
---
## Algoritmos do Framework
O artigo apresenta dois algoritmos principais que descrevem o funcionamento do controle de voz dentro do framework.
### **Algoritmo 1 — Interação Usuário ↔ Sistema Inteligente**
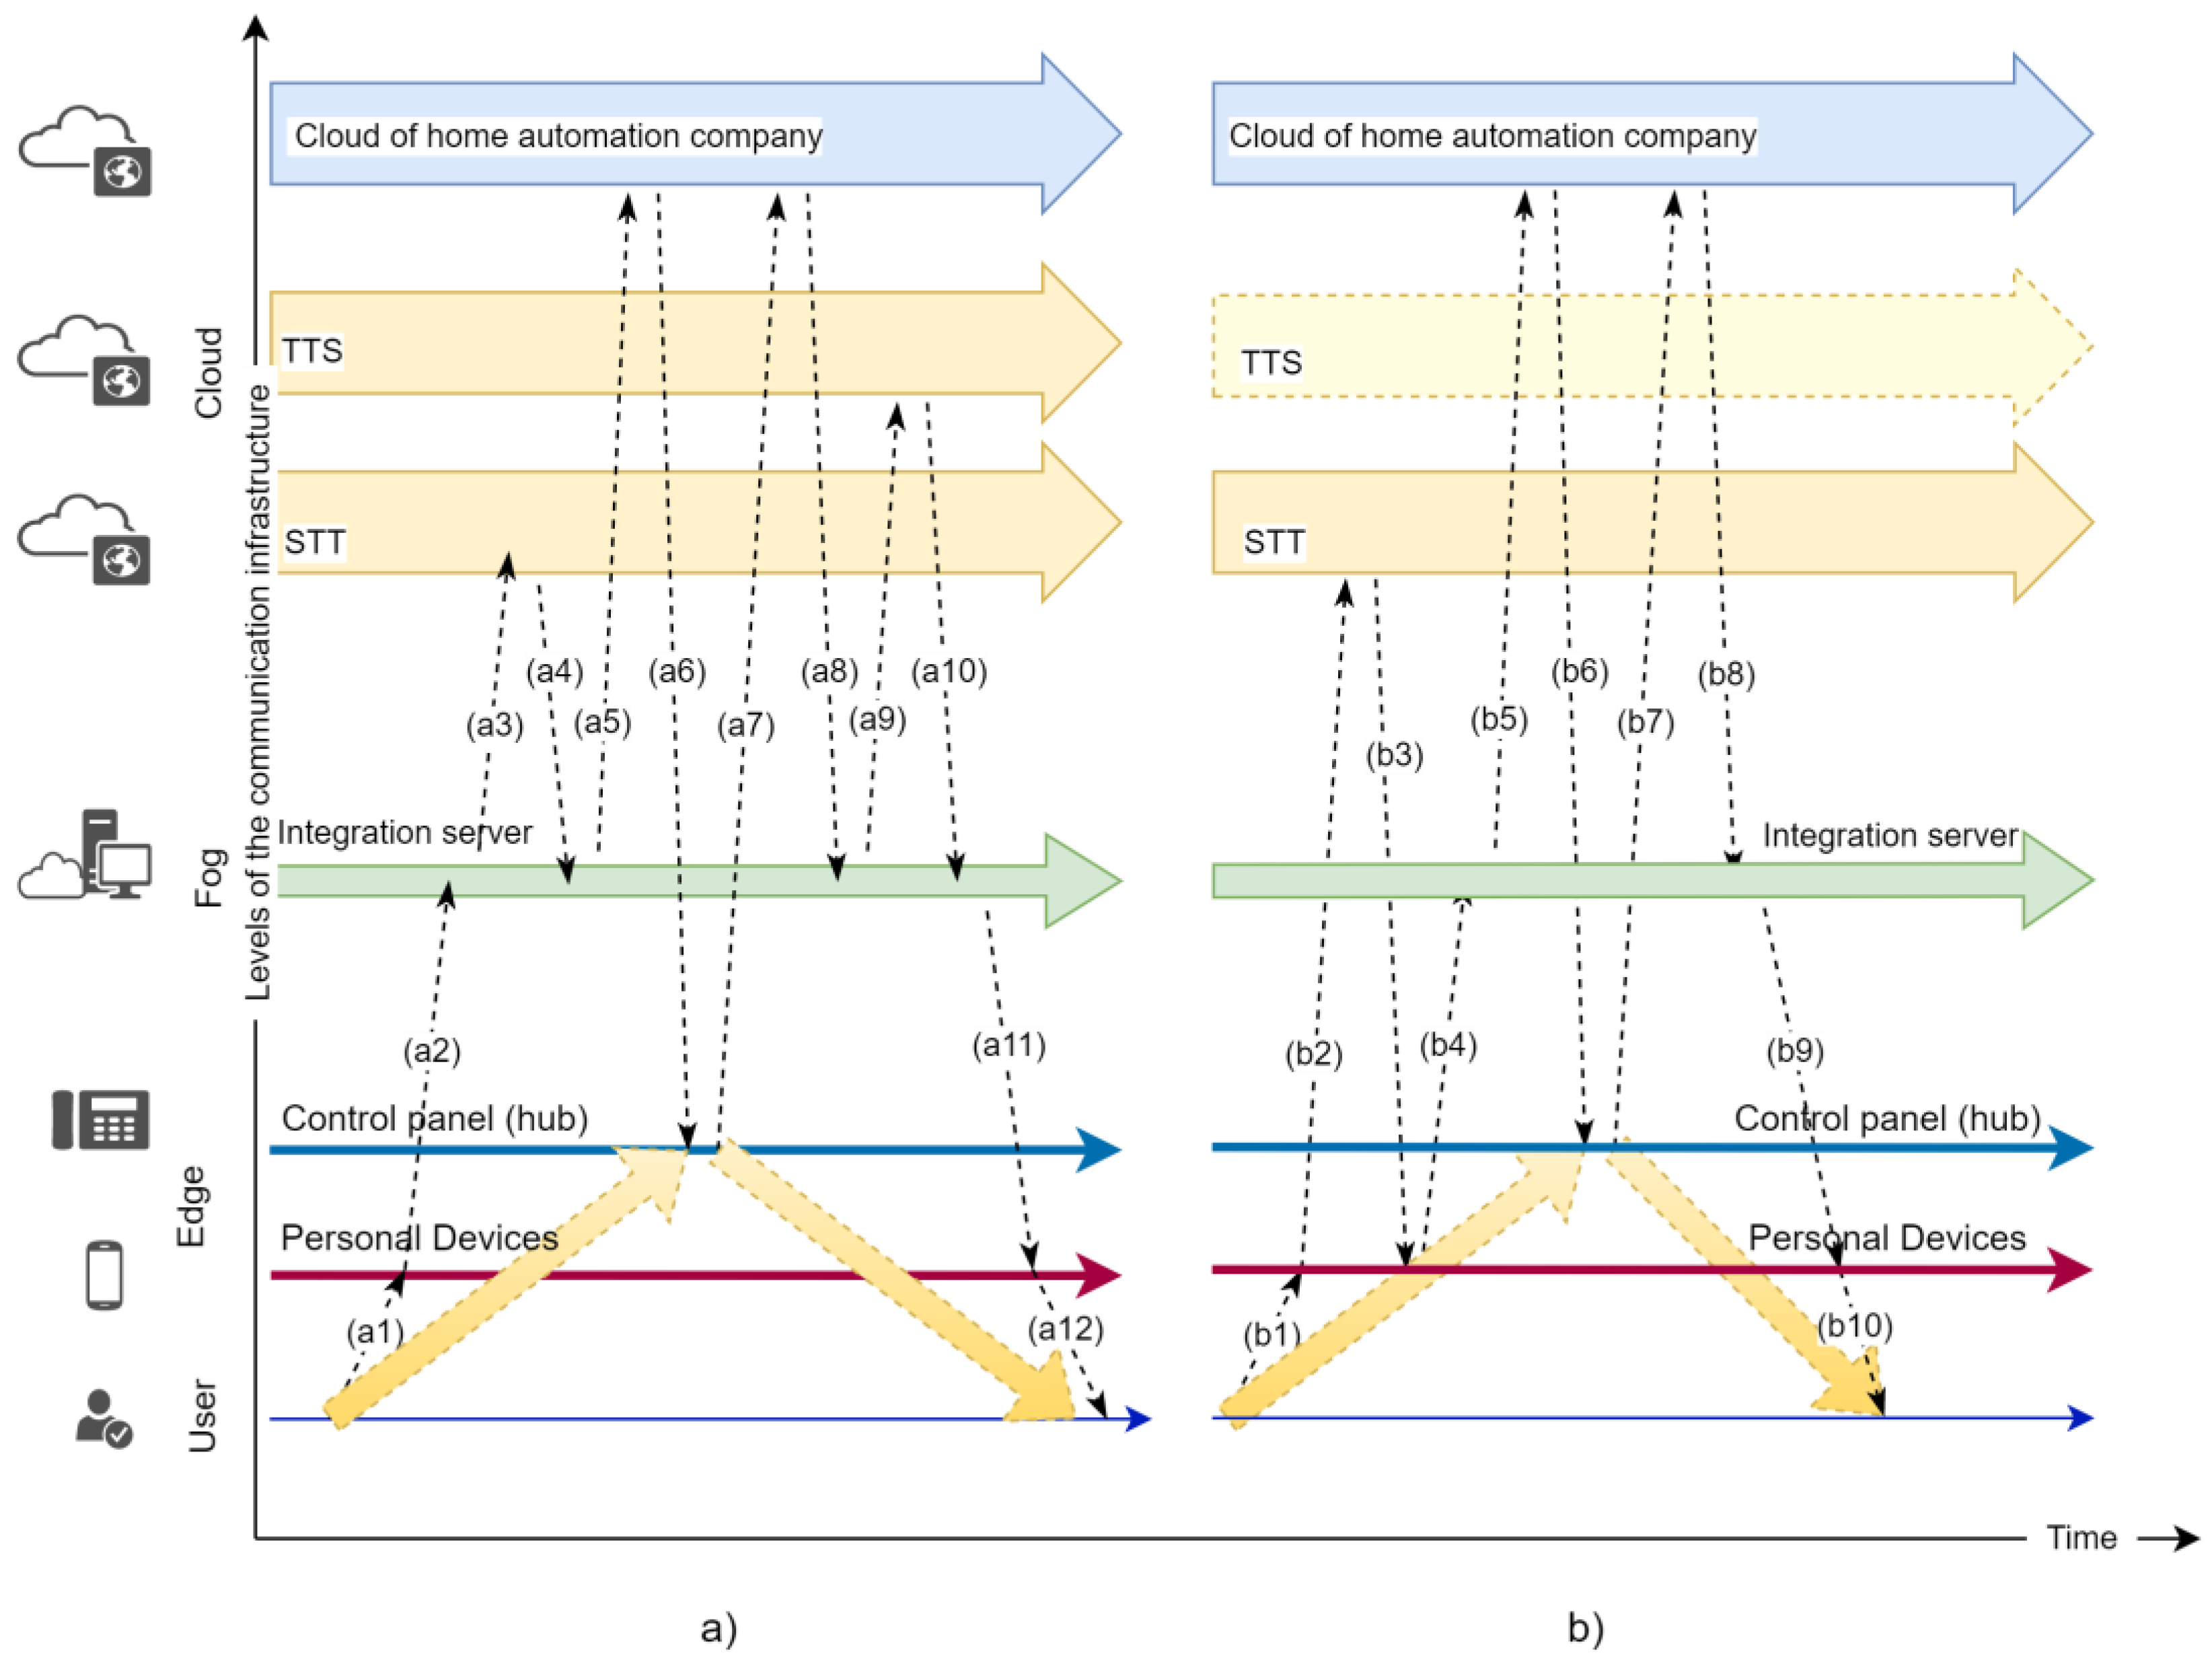 *Fonte: Iliev & Ilieva, 2023 (CC BY 4.0).*
Este algoritmo descreve o **caminho da fala do usuário até a execução do comando**.
O processo segue uma sequência de 12 passos principais:
1. O usuário fala um comando (ex.: “ligar as luzes da sala”).
2. O dispositivo grava o áudio e o envia ao **servidor de integração (fog)**.
3. O **módulo IUI** envia o áudio para o serviço **STT (Speech-to-Text)**.
4. O texto retornado é analisado para extrair o **significado da frase**.
5. A intenção identificada é enviada ao **hub central (Cloud of Home Automation Company)**.
6. O comando é validado e encaminhado ao subsistema responsável (ex.: iluminação).
7. O dispositivo executa a ação e envia uma resposta.
8. A resposta retorna ao servidor e é convertida em texto.
9. O texto é transformado em fala via **TTS (Text-to-Speech)**.
10. O arquivo de áudio resultante é enviado de volta ao usuário.
11. O dispositivo reproduz a resposta (“As luzes da sala foram ligadas”).
💡 *O sistema pode pular etapas (como TTS ou STT em cache) para acelerar o tempo de resposta.*
---
### **Algoritmo 2 — Detecção de Intenção (Intent Detection)**
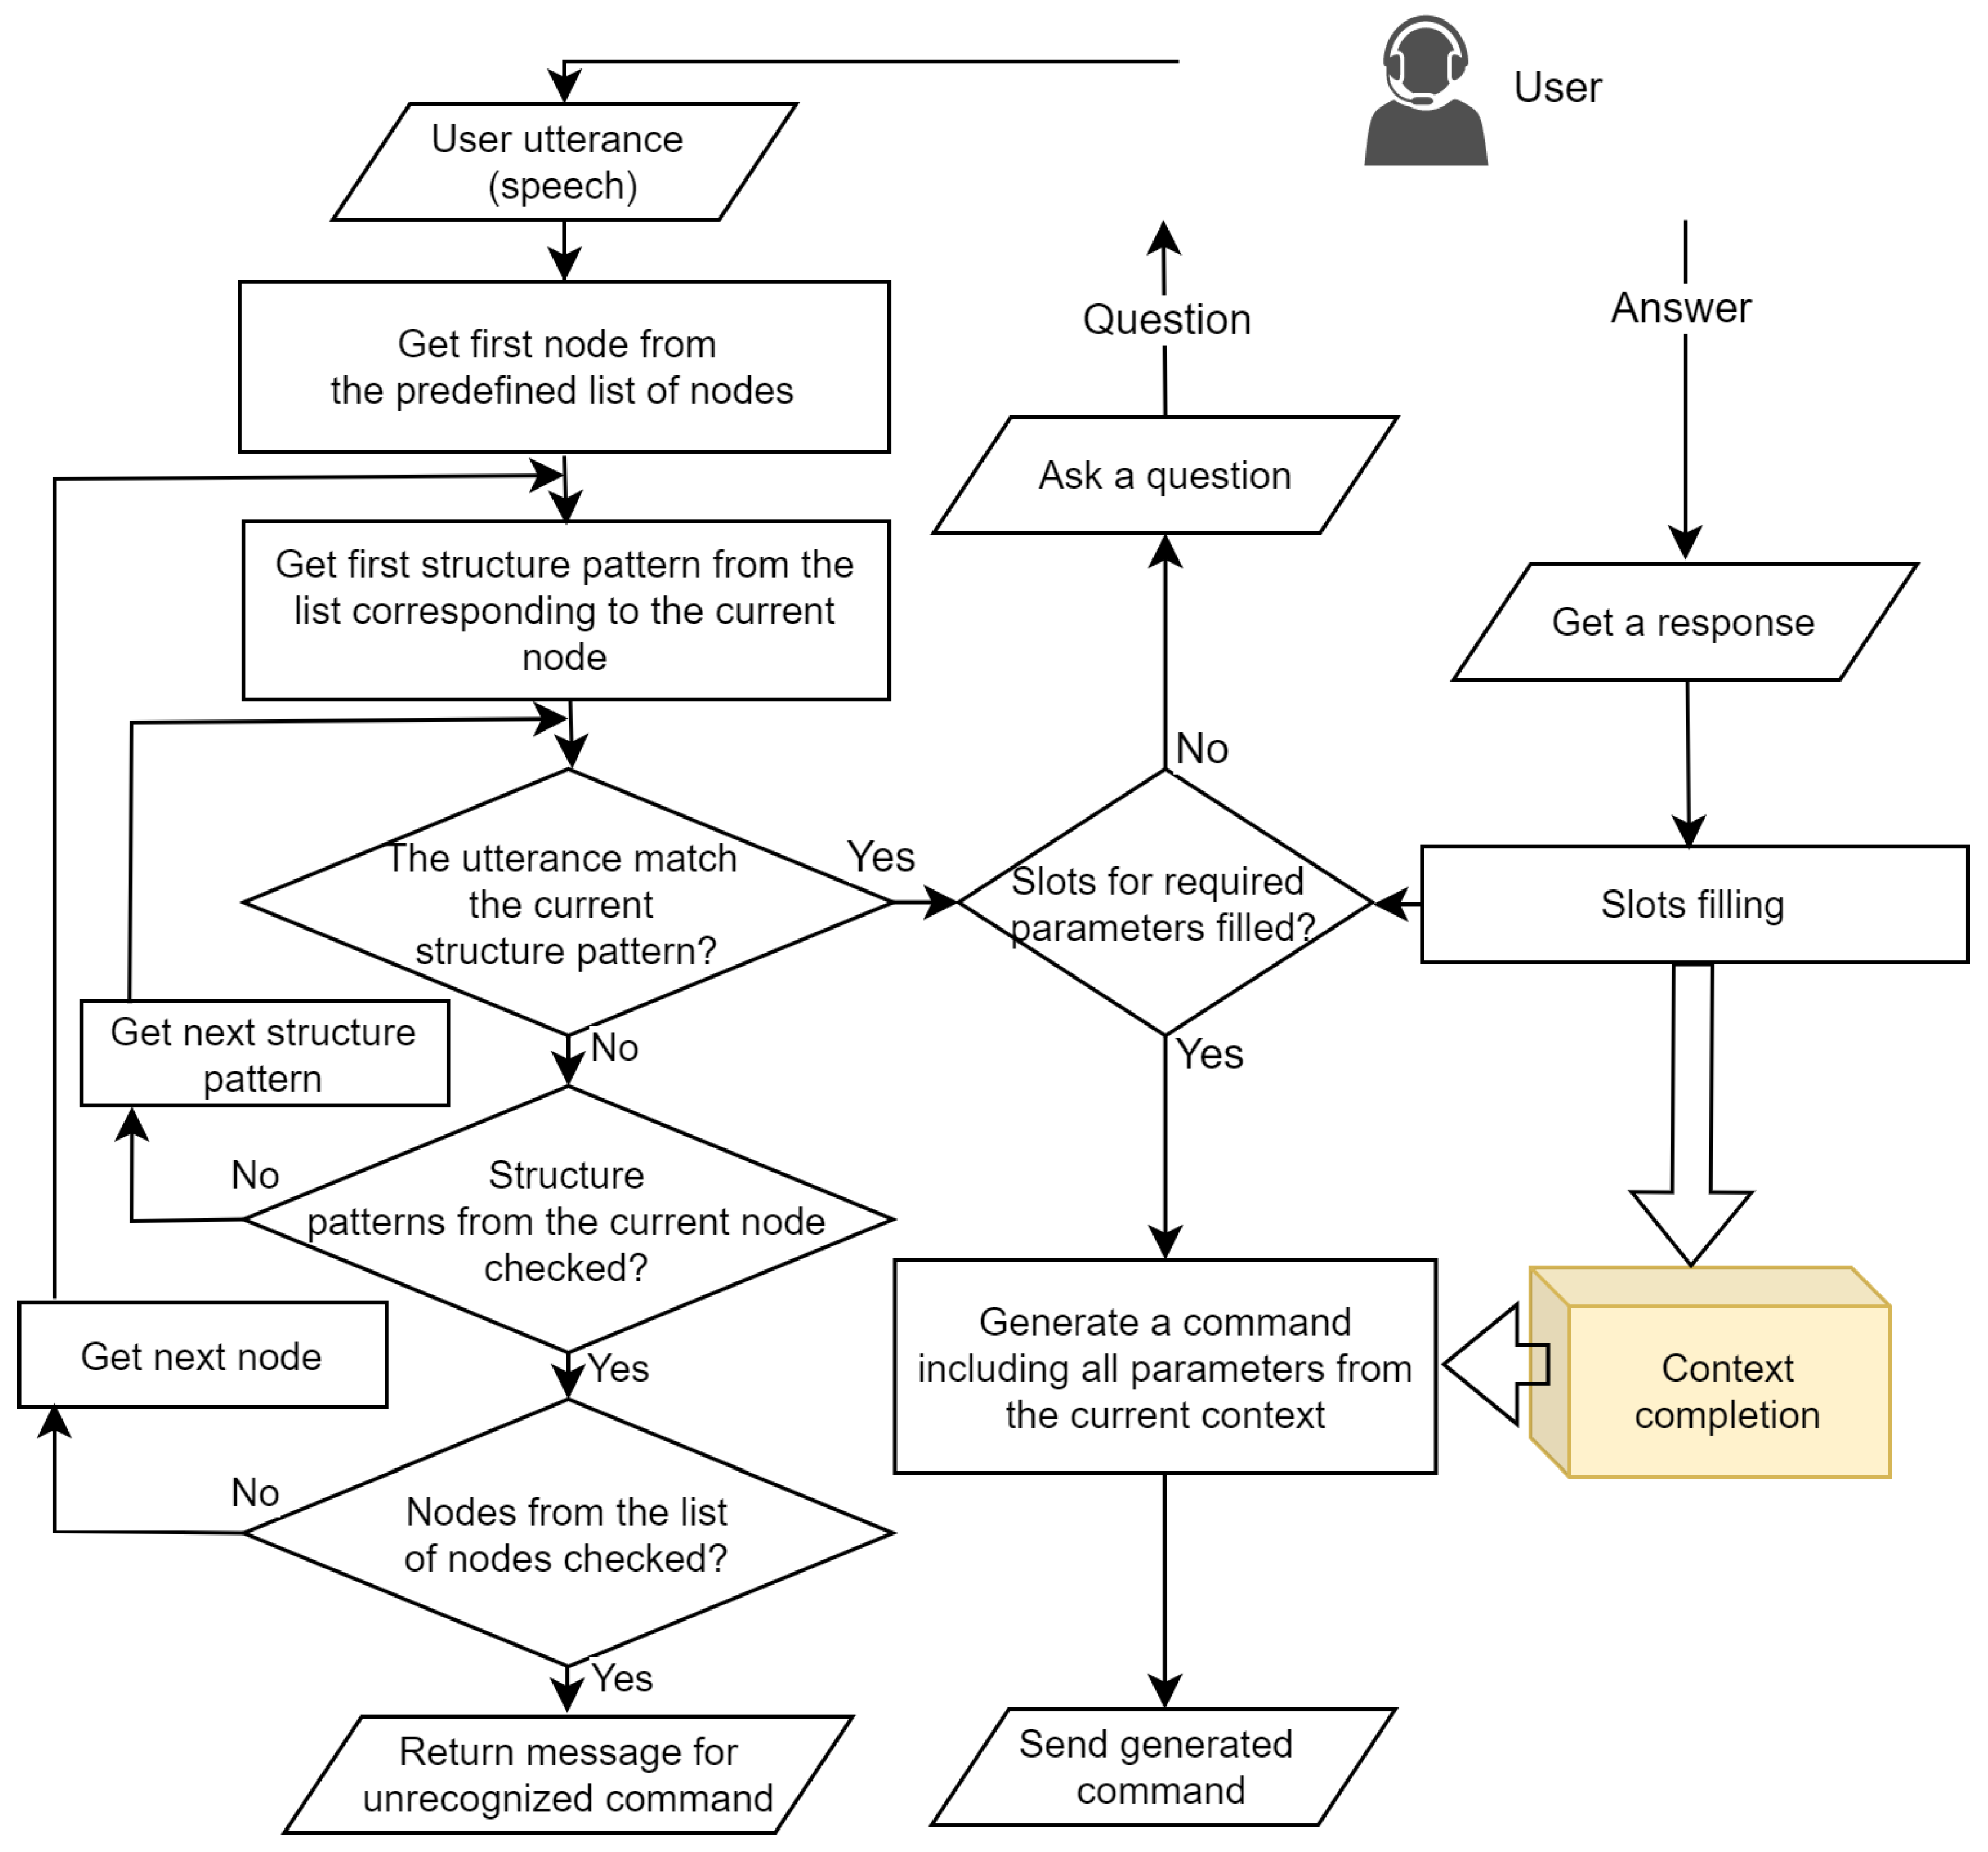 *Fonte: Iliev & Ilieva, 2023 (CC BY 4.0).*
Esse segundo algoritmo é o **núcleo da inteligência linguística**. Ele identifica **o que o usuário quer dizer** e **gera o comando correto**.
O funcionamento se baseia em estruturas semânticas chamadas **nós**, **padrões estruturais** e **slots**:
1. A fala do usuário é convertida em texto (via STT).
2. O sistema percorre uma lista de **nós (nodes)** — cada um representa um tipo de comando (ex.: luz, temperatura, segurança).
3. Para cada nó, o sistema verifica **padrões estruturais** que definem possíveis formas de frase (sinônimos, ordem das palavras, etc.).
4. Quando um padrão coincide com a frase, a intenção é reconhecida.
5. Se faltam informações (por exemplo, o cômodo), o sistema faz **perguntas de esclarecimento**.
6. Após coletar todos os parâmetros, o sistema **gera o comando formal** e o envia para execução.
7. Se nenhum padrão for identificado, o sistema retorna uma mensagem de **comando não reconhecido**.
🔹 **Em resumo:** o Algoritmo 2 é o cérebro semântico, responsável por entender o significado e transformar a fala em uma ação concreta.
---
## Módulo de Voz e Processamento Semântico
O sistema integra três componentes principais:
1. **STT (Speech-to-Text):** converte fala em texto.
2. **TTS (Text-to-Speech):** converte texto em fala.
3. **NLU (Natural Language Understanding):** interpreta intenções e parâmetros.
Operando principalmente na **camada Fog**, o módulo garante:
- Respostas rápidas e locais;
- Privacidade de dados sensíveis;
- Suporte a múltiplos idiomas, inclusive pouco representados.
🔹 **Analogia com Echo Dot:** Assim como o Echo Dot processa localmente a palavra “Alexa”, o framework propõe executar parte da compreensão de linguagem na fog layer — reduzindo dependência da nuvem e aumentando eficiência.
---
## Contribuições e Relevância para Sistemas Embarcados
| Contribuição | Aplicação ao Echo Dot |
|---------------|----------------------|
| **Suporte a idiomas sub-representados** | Expande o controle de voz para idiomas regionais. |
| **Processamento distribuído (Edge/Fog)** | Menor latência e maior desempenho. |
| **Autonomia e redução de custos** | Menos dependência de nuvem e serviços pagos. |
| **Segurança e privacidade aprimoradas** | Processamento local de dados sensíveis. |
| **Escalabilidade e portabilidade** | Framework replicável para outros dispositivos e contextos. |
---
## Conclusão
O framework IoT–Fog–Cloud apresentado por **Iliev & Ilieva** demonstra que é possível criar interfaces de voz descentralizadas, seguras e multilíngues, aplicáveis a sistemas embarcados como o **Echo Dot (5ª geração)**.
A arquitetura propõe uma nova forma de interação homem–máquina, baseada em inteligência local e interoperabilidade, abrindo caminho para assistentes de voz mais autônomos, inclusivos e eficientes.